Domain text-mining.de kaufen?
Wir ziehen mit dem Projekt
text-mining.de um.
Sind Sie am Kauf der Domain
text-mining.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain text-mining.de kaufen?
Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Diese Methoden werden verwendet, um ähnliche Datenpunkte in Gruppen zu organisieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
Was sind die verschiedenen Methoden und Anwendungen des Clustering in der Datenanalyse?
Clustering ist eine Methode zur Gruppierung von Datenpunkten basierend auf deren Ähnlichkeiten. Es gibt verschiedene Algorithmen wie K-Means, Hierarchisches Clustering und DBSCAN, die für das Clustering verwendet werden können. Anwendungen des Clusterings in der Datenanalyse sind unter anderem Kunden-Segmentierung, Anomalie-Erkennung und Mustererkennung. **
Ähnliche Suchbegriffe für Methoden
Top-Angebote
Produkte zum Begriff Methoden:
-
Lorelei Kopp - Mindful Leadership: Tools & Methoden für achtsames Führen in turbulenten Zeiten - Preis vom 31.10.2026 20:28:10 hBinding : Taschenbuch, Label : Independently published, Publisher : Independently published, medium : Taschenbuch, numberOfPages : 144, publicationDate : 2021-05-18, authors : Lorelei Kopp8,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die wichtigsten Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse?
Die wichtigsten Methoden zur Anwendung von Clustering-Algorithmen sind k-means, hierarchisches Clustering und DBSCAN. K-means teilt die Daten in k Gruppen auf, hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. Diese Methoden helfen dabei, Muster und Strukturen in den Daten zu identifizieren und zu verstehen. **
-
Was sind die gängigen Methoden zur Durchführung von Clustering-Analysen in der Datenanalyse?
Die gängigen Methoden zur Durchführung von Clustering-Analysen sind k-means, hierarchisches Clustering und DBSCAN. K-means ist ein partitionierender Algorithmus, der die Daten in k Gruppen einteilt. Hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. **
-
Was sind die verschiedenen Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse?
Die verschiedenen Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. K-means teilt die Daten in k Gruppen auf, hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. Jede Methode hat ihre eigenen Vor- und Nachteile und eignet sich für unterschiedliche Arten von Daten. **
-
Was sind die gängigen Methoden zur Implementierung von Clustering-Algorithmen in der Datenanalyse?
Die gängigen Methoden zur Implementierung von Clustering-Algorithmen in der Datenanalyse sind die Verwendung von Bibliotheken wie scikit-learn in Python, die Nutzung von spezialisierten Softwaretools wie RapidMiner oder Weka und die Entwicklung eigener Algorithmen in Programmiersprachen wie R oder Java. Es ist wichtig, die richtige Methode basierend auf den Anforderungen des Projekts und der Expertise des Teams auszuwählen. Die Implementierung sollte auch regelmäßig überprüft und optimiert werden, um die bestmöglichen Ergebnisse zu erzielen. **

Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse und Mustererkennung?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Clustering wird verwendet, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
Welche Tools und Methoden werden üblicherweise beim Text Mining verwendet und wie können sie zur Extraktion von Informationen aus großen Textmengen eingesetzt werden?
Beim Text Mining werden Tools wie Natural Language Processing, Machine Learning und Data Mining eingesetzt, um strukturierte Informationen aus unstrukturierten Textdaten zu extrahieren. Diese Tools können verwendet werden, um Muster, Trends und Zusammenhänge in großen Textmengen zu identifizieren und somit wertvolle Erkenntnisse für Unternehmen zu gewinnen. Durch die Anwendung von Text Mining können Unternehmen beispielsweise Kundenfeedback analysieren, Markttrends erkennen oder Risiken frühzeitig identifizieren. **
Top-Angebote
Produkte zum Begriff Methoden:
-
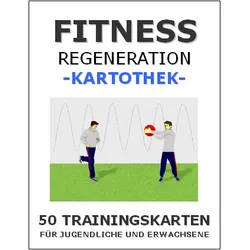
Trainingskartothek - "Methoden der Regeneration"Kartothek "Die Regeneration"50 innovative Trainingskarten mit RegenerationsmethodenSchwerpunkt "Regeneration"Sie erhalten 50 Trainingskarten, mit Trainingsübungen auf stabilem Karton, in DIN A6 Grösse. Schwerpunkt: Methoden der Regeneration für Jugendliche und Erwachsene. Diese innovativen Trainingsübungen sind nicht im Handel erhältlich, sondern nur bei uns. Wir haben diese Übungen zusammen mit einem erfahrenen Trainerteam verfasst und zusammengestellt. Es handelt sich um sehr verständlich aufgebaute Trainingsübungen, kombiniert mit exzellent animierten Farbgrafiken. Diese Trainings-Kartothek mit mehr als 50 intelligenten Trainingskarten, hilft Ihnen das tägliche Training abwechslungsreich zu gestalten. Ein umfangreiches Regenerationsprogramm ist nun kein Problem mehr. Einige deutsche Profivereine arbeiten bereits mit unseren Trainingsmaterialien.Trainingsschwerpunkte derKartothek "Regeneration":passive Regeneration Entspannung der Muskulatur mentale Entspannung Intensivierung der Hautdurchblutung Auslösen regenerativer Reflexe Intensivierung des Stoffwechsels Verbesserung der Regenerationskapazität Schmerzlinderung, Abhärtung Massageeffekt Verbesserung der Sauerstoffversorgung Stimulation des Immunsystems Erholung, Superkompensation Ausgleich von Flüssigkeitsverlust Gewährleistung des Trainingsniveaus Normalisierung aller Körperfunktionen Beruhigung des Kreislaufs Abnahme der Erregung und Anspannung usw. Viel Erfolg beim Training!12,90 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Diese Methoden werden verwendet, um ähnliche Datenpunkte in Gruppen zu organisieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
-
Was sind die verschiedenen Methoden und Anwendungen des Clustering in der Datenanalyse?
Clustering ist eine Methode zur Gruppierung von Datenpunkten basierend auf deren Ähnlichkeiten. Es gibt verschiedene Algorithmen wie K-Means, Hierarchisches Clustering und DBSCAN, die für das Clustering verwendet werden können. Anwendungen des Clusterings in der Datenanalyse sind unter anderem Kunden-Segmentierung, Anomalie-Erkennung und Mustererkennung. **
-
Was sind die wichtigsten Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse?
Die wichtigsten Methoden zur Anwendung von Clustering-Algorithmen sind k-means, hierarchisches Clustering und DBSCAN. K-means teilt die Daten in k Gruppen auf, hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. Diese Methoden helfen dabei, Muster und Strukturen in den Daten zu identifizieren und zu verstehen. **
-
Was sind die gängigen Methoden zur Durchführung von Clustering-Analysen in der Datenanalyse?
Die gängigen Methoden zur Durchführung von Clustering-Analysen sind k-means, hierarchisches Clustering und DBSCAN. K-means ist ein partitionierender Algorithmus, der die Daten in k Gruppen einteilt. Hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. **
Ähnliche Suchbegriffe für Methoden
-
Lorelei Kopp - Mindful Leadership: Tools & Methoden für achtsames Führen in turbulenten Zeiten - Preis vom 31.10.2026 20:28:10 hBinding : Taschenbuch, Label : Independently published, Publisher : Independently published, medium : Taschenbuch, numberOfPages : 144, publicationDate : 2021-05-18, authors : Lorelei Kopp8,49 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
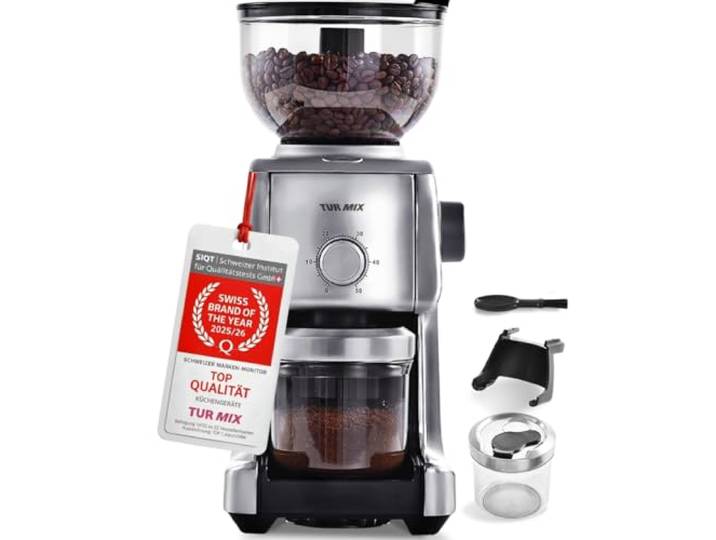
Kaffeemühle Elektrisch mit Kegelmahlwerk 16 Stufen für Siebträger 400g Timer und Direktmahlung in den Siebträger; 400-g-Bohnenbehälter für Espresso, Filterkaffee und weitere Methoden.Kaffeemühle Elektrisch mit Kegelmahlwerk 16 Stufen für Siebträger 400g Timer und Direktmahlung in den Siebträger; 400-g-Bohnenbehälter für Espresso, Filterkaffee und weitere Methoden.. 1. Elektrische Kaffeemühle mit Kegelmahlwerk Präzises Edelstahl-Kegelmahlwerk mit 16 Stufen – aromaschonend & gleichmäßig. Diese espressomühle liefert ideale Ergebnisse für Espresso, Filterkaffee oder French Press. 2. Direktmahlung für Siebträger oder Behälter Nutzen Sie die kaffeemühle siebträger-kompatibel: mahlt direkt in den Siebträger oder in den 240 g-Behälter – bequem, schnell & ohne Umfüllen. 3. Exakte Timerfunktion (1–50 Sek.) für perfekte Dosierung Ob kräftiger Espresso oder milder Filterkaffee – die kaffee mühle passt sich Ihrem Geschmack an. Auch für die tägliche Nutzung als elektrische mühle bestens geeignet. 4. Herausnehmbarer Bohnenbehälter für 400 g Viel Platz für Ihre Lieblingsbohnen. Diese kaffeemühle elektrisch testsieger-würdig kombiniert Kapazität, Komfort & Leistung für wahre Kaffeeliebhaber. 5. Kompakte Bauweise & hochwertiges Design (Chrom) Mit nur 16 × 36 × 20 cm & 3 kg ist sie ideal für jede Küche. Die kaffeemühlen-Serie von Turmix steht für Qualität, Langlebigkeit & moderne Optik. Farbe:Kaffeemühle Tx 190139,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die verschiedenen Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse?
Die verschiedenen Methoden zur Anwendung von Clustering-Algorithmen in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. K-means teilt die Daten in k Gruppen auf, hierarchisches Clustering erstellt eine Baumstruktur der Daten und DBSCAN identifiziert dichte Regionen in den Daten. Jede Methode hat ihre eigenen Vor- und Nachteile und eignet sich für unterschiedliche Arten von Daten. **
-
Was sind die gängigen Methoden zur Implementierung von Clustering-Algorithmen in der Datenanalyse?
Die gängigen Methoden zur Implementierung von Clustering-Algorithmen in der Datenanalyse sind die Verwendung von Bibliotheken wie scikit-learn in Python, die Nutzung von spezialisierten Softwaretools wie RapidMiner oder Weka und die Entwicklung eigener Algorithmen in Programmiersprachen wie R oder Java. Es ist wichtig, die richtige Methode basierend auf den Anforderungen des Projekts und der Expertise des Teams auszuwählen. Die Implementierung sollte auch regelmäßig überprüft und optimiert werden, um die bestmöglichen Ergebnisse zu erzielen. **
-
Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse und Mustererkennung?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Clustering wird verwendet, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
-
Welche Tools und Methoden werden üblicherweise beim Text Mining verwendet und wie können sie zur Extraktion von Informationen aus großen Textmengen eingesetzt werden?
Beim Text Mining werden Tools wie Natural Language Processing, Machine Learning und Data Mining eingesetzt, um strukturierte Informationen aus unstrukturierten Textdaten zu extrahieren. Diese Tools können verwendet werden, um Muster, Trends und Zusammenhänge in großen Textmengen zu identifizieren und somit wertvolle Erkenntnisse für Unternehmen zu gewinnen. Durch die Anwendung von Text Mining können Unternehmen beispielsweise Kundenfeedback analysieren, Markttrends erkennen oder Risiken frühzeitig identifizieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.