Domain text-mining.de kaufen?
Wir ziehen mit dem Projekt
text-mining.de um.
Sind Sie am Kauf der Domain
text-mining.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain text-mining.de kaufen?
Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse und Mustererkennung?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Clustering wird verwendet, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
Was sind die verschiedenen Ansätze für Clustering-Algorithmen und wie können sie zur Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Ansätze für Clustering-Algorithmen umfassen hierarchische, partitionierende und dichte-basierte Methoden. Diese Algorithmen können zur Gruppierung von Datenpunkten basierend auf Ähnlichkeiten oder Distanzen verwendet werden. Durch die Anwendung von Clustering-Algorithmen können Muster in den Daten identifiziert und für die Datenanalyse und Mustererkennung genutzt werden. **

Ähnliche Suchbegriffe für Mustererkennung
Top-Angebote
Produkte zum Begriff Mustererkennung:

-
Was sind die wichtigsten Vorteile von Clustering-Algorithmen in der Datenanalyse und wie können sie zur Mustererkennung verwendet werden?
Clustering-Algorithmen helfen, Daten in Gruppen zu organisieren, was dabei hilft, Muster und Strukturen in den Daten zu erkennen. Sie ermöglichen es, große Datenmengen effizient zu analysieren und Zusammenhänge zwischen den Datenpunkten zu identifizieren. Durch die Anwendung von Clustering-Algorithmen können Unternehmen beispielsweise Kundensegmente identifizieren und personalisierte Marketingstrategien entwickeln. **
-
Wie können Algorithmen zur Mustererkennung in der Datenanalyse und im maschinellen Lernen eingesetzt werden?
Algorithmen zur Mustererkennung können verwendet werden, um komplexe Datenmuster zu identifizieren und Vorhersagen zu treffen. Sie können in der Datenanalyse eingesetzt werden, um Trends, Anomalien und Zusammenhänge in den Daten zu erkennen. Im maschinellen Lernen können Algorithmen zur Mustererkennung verwendet werden, um Modelle zu trainieren, die automatisch Muster in den Daten erkennen und darauf basierend Entscheidungen treffen können. **
-
Was ist eine Affinitätsmatrix und wie wird sie in der Datenanalyse und Mustererkennung verwendet?
Eine Affinitätsmatrix ist eine mathematische Darstellung von Beziehungen zwischen Objekten. Sie wird verwendet, um Ähnlichkeiten oder Unterschiede zwischen Objekten zu quantifizieren. In der Datenanalyse und Mustererkennung wird die Affinitätsmatrix verwendet, um Cluster von ähnlichen Objekten zu identifizieren oder um Muster in den Daten zu erkennen. **
-
Wie können Mustererkennungssysteme dazu beitragen, die Effizienz und Genauigkeit von Datenanalyse und Mustererkennung zu verbessern?
Mustererkennungssysteme können große Datenmengen schnell und präzise analysieren, um Muster und Trends zu identifizieren. Durch den Einsatz von Algorithmen können sie automatisch Muster erkennen, die für menschliche Analysten möglicherweise schwer zu erkennen sind. Dies führt zu einer effizienteren und genaueren Datenanalyse und Mustererkennung. **


Versteht jemand von euch Mustererkennung bei Matrizentests?
Ja, ich verstehe Mustererkennung bei Matrizentests. Mustererkennung bezieht sich auf die Fähigkeit, wiederkehrende Muster oder Strukturen in einer Matrix zu identifizieren und zu interpretieren. Dies kann beispielsweise bei der Analyse von Daten oder der Lösung von mathematischen Problemen hilfreich sein. **
Was sind die verschiedenen Methoden des Clusterings und wie können sie in der Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Methoden des Clusterings sind k-means, hierarchisches Clustering und DBSCAN. Sie können in der Datenanalyse verwendet werden, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Diese Methoden helfen dabei, komplexe Daten zu strukturieren und Einblicke in die zugrunde liegenden Muster und Beziehungen zu gewinnen. **
Top-Angebote
Produkte zum Begriff Mustererkennung:
-
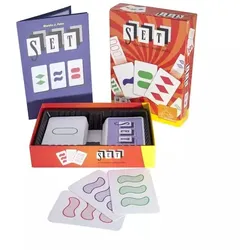
SET - das ungarische Gesellschaftsspiel zur MustererkennungEin wirklich cleveres Kartenspiel für die ganze Familie! SET ist das Spiel der Erkennung von Kombinationsmöglichkeiten, des schnellen Erfassens von Situationen und noch schnelleren Reaktionen. Ziel des Spiels ist es, SETs unter den aufgedeckten Karten zu finden. Jede Karte hat vier Merkmale: Farbe (rot, grün, lila), Form (oval, wellenförmig, Raute), Anzahl (eins, zwei, drei) und Füllung (voll, gestreift, leer). Ein SET besteht aus drei Karten, bei denen sich diese vier Merkmale entweder gleichen oder unterscheiden. Aber niemals dürfen zwei gleich sein und das dritte verschieden, denn das ist kein SET! Bist du bereit?14,39 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden und Anwendungen von Clustering in der Datenanalyse und Mustererkennung?
Die wichtigsten Methoden von Clustering in der Datenanalyse sind k-means, hierarchisches Clustering und DBSCAN. Clustering wird verwendet, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Anwendungen von Clustering sind unter anderem in der Marktforschung, medizinischen Diagnose und Bilderkennung. **
-
Was sind die verschiedenen Ansätze für Clustering-Algorithmen und wie können sie zur Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Ansätze für Clustering-Algorithmen umfassen hierarchische, partitionierende und dichte-basierte Methoden. Diese Algorithmen können zur Gruppierung von Datenpunkten basierend auf Ähnlichkeiten oder Distanzen verwendet werden. Durch die Anwendung von Clustering-Algorithmen können Muster in den Daten identifiziert und für die Datenanalyse und Mustererkennung genutzt werden. **
-
Was sind die wichtigsten Vorteile von Clustering-Algorithmen in der Datenanalyse und wie können sie zur Mustererkennung verwendet werden?
Clustering-Algorithmen helfen, Daten in Gruppen zu organisieren, was dabei hilft, Muster und Strukturen in den Daten zu erkennen. Sie ermöglichen es, große Datenmengen effizient zu analysieren und Zusammenhänge zwischen den Datenpunkten zu identifizieren. Durch die Anwendung von Clustering-Algorithmen können Unternehmen beispielsweise Kundensegmente identifizieren und personalisierte Marketingstrategien entwickeln. **
-
Wie können Algorithmen zur Mustererkennung in der Datenanalyse und im maschinellen Lernen eingesetzt werden?
Algorithmen zur Mustererkennung können verwendet werden, um komplexe Datenmuster zu identifizieren und Vorhersagen zu treffen. Sie können in der Datenanalyse eingesetzt werden, um Trends, Anomalien und Zusammenhänge in den Daten zu erkennen. Im maschinellen Lernen können Algorithmen zur Mustererkennung verwendet werden, um Modelle zu trainieren, die automatisch Muster in den Daten erkennen und darauf basierend Entscheidungen treffen können. **
Ähnliche Suchbegriffe für Mustererkennung
-
Fettsäure-Analyse Selbsttest NorsanAnwendungsgebiet von Fettsäure-Analyse Selbsttest NorsanMit dem Fettsäure-Analyse Selbsttest Norsan können Sie bequem von Zuhause Ihre Fettsäurewerte bestimmen lassen. Gemessen wird das Omega-6/3-Verhältnis, der Omega3-Index sowie 26 Fettsäuren. Die Auswertung Ihres Blutes wird von einem unabhängigen Labor durchgeführt. Der individuelle Bedarf an Omega 3 lässt sich mithilfe des Selbsttests zur Analyse des Fettsäure- und Omega-Profils (NORSAN Analyse) belegen. Mit einigen Tropfen Blut aus der Fingerbeere wird Ihr Fettsäure-Profil analysiert und Sie erhalten unter anderem Informationen zu: Omega-3 Index: Gibt den Anteil der marinen Omega-3-Fettsäuren EPA und DHA im Verhältnis zu den gesamten Fettsäuren an. NORSAN empfiehlt einen Anteil von über 8 %. Omega 6/3-Verhältnis: Weist auf das Verhältnis zwischen Omega-6 und Omega-3-Fettsäuren hin, die bei der Entzündungsbildung und -hemmung entscheidend mitwirken. Ein zu hohes Omega-6/3 Verhältnis (Omega-3-Ratio) führt zu einem unerwünscht hohen Entzündungsniveau im Körper. Transfett-Anteil: Transfette sind Fettstoffe, die nicht natürlich in den Körper gehören. Transfette schaden den Zellen. Der Transfett-Anteil sollte niedrig sein. Es wird empfohlen, dass die industriellen Transfette weniger als 0,50 % der gesamten Fettsäuren ausmachen sollen. Wirkstoffe / Inhaltsstoffe / ZutatenIm Lieferumfang enthalten:- Bestellanforderung für die Blutanalyse - Blutentnahmeset mit Nadel- Folienbeutel- Test-Papier zum Auftrag des entnommenen Blutes und frankierten Rücksendeumschlag - Anleitung zur Blutentnahme und Anforderung des Analyseergebnisses - Auswertung durch ein unabhängiges Labor - Anschließend Befund mit ErnährungsempfehlungGegenanzeigenBei bekannter Überempfindlichkeit gegenüber einem der oben genannten Inhaltsstoffe sollte dieses Produkt nicht angewendet werden. Fettsäure-Analyse Selbsttest Norsan können in Ihrer Versandapotheke www.juvalis.de er70,76 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist eine Affinitätsmatrix und wie wird sie in der Datenanalyse und Mustererkennung verwendet?
Eine Affinitätsmatrix ist eine mathematische Darstellung von Beziehungen zwischen Objekten. Sie wird verwendet, um Ähnlichkeiten oder Unterschiede zwischen Objekten zu quantifizieren. In der Datenanalyse und Mustererkennung wird die Affinitätsmatrix verwendet, um Cluster von ähnlichen Objekten zu identifizieren oder um Muster in den Daten zu erkennen. **
-
Wie können Mustererkennungssysteme dazu beitragen, die Effizienz und Genauigkeit von Datenanalyse und Mustererkennung zu verbessern?
Mustererkennungssysteme können große Datenmengen schnell und präzise analysieren, um Muster und Trends zu identifizieren. Durch den Einsatz von Algorithmen können sie automatisch Muster erkennen, die für menschliche Analysten möglicherweise schwer zu erkennen sind. Dies führt zu einer effizienteren und genaueren Datenanalyse und Mustererkennung. **
-
Versteht jemand von euch Mustererkennung bei Matrizentests?
Ja, ich verstehe Mustererkennung bei Matrizentests. Mustererkennung bezieht sich auf die Fähigkeit, wiederkehrende Muster oder Strukturen in einer Matrix zu identifizieren und zu interpretieren. Dies kann beispielsweise bei der Analyse von Daten oder der Lösung von mathematischen Problemen hilfreich sein. **
-
Was sind die verschiedenen Methoden des Clusterings und wie können sie in der Datenanalyse und Mustererkennung eingesetzt werden?
Die verschiedenen Methoden des Clusterings sind k-means, hierarchisches Clustering und DBSCAN. Sie können in der Datenanalyse verwendet werden, um ähnliche Datenpunkte zu gruppieren und Muster in den Daten zu identifizieren. Diese Methoden helfen dabei, komplexe Daten zu strukturieren und Einblicke in die zugrunde liegenden Muster und Beziehungen zu gewinnen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.